SERVER PLUS INSIGHTS
HPE DL380 Gen10で企業向けオンプレミスAI:RTX A6000 1枚でQwen3.8-Flash-Nextを導入
整備済みサーバーも企業のオンプレミスAI基盤になります。Server PlusがDL380 Gen10、RTX A6000 48GB 1枚、Strataを使用した大規模MoEモデルの導入事例を、ハードウェア構成から業務連携まで紹介します。
2026-11-10 · Server Plus
Server Plusが整備済みHPE DL380 Gen10、RTX A6000 48GB、128GB RAMでStrataとQwen3.8-Flash-Nextを導入。構成、推論性能、企業向けAIの用途を紹介します。
導入の概要
整備済み企業向けサーバーはオンプレミスAI推論の基盤として利用でき、企業はワークロードと予算に応じて計算資源を計画できます。
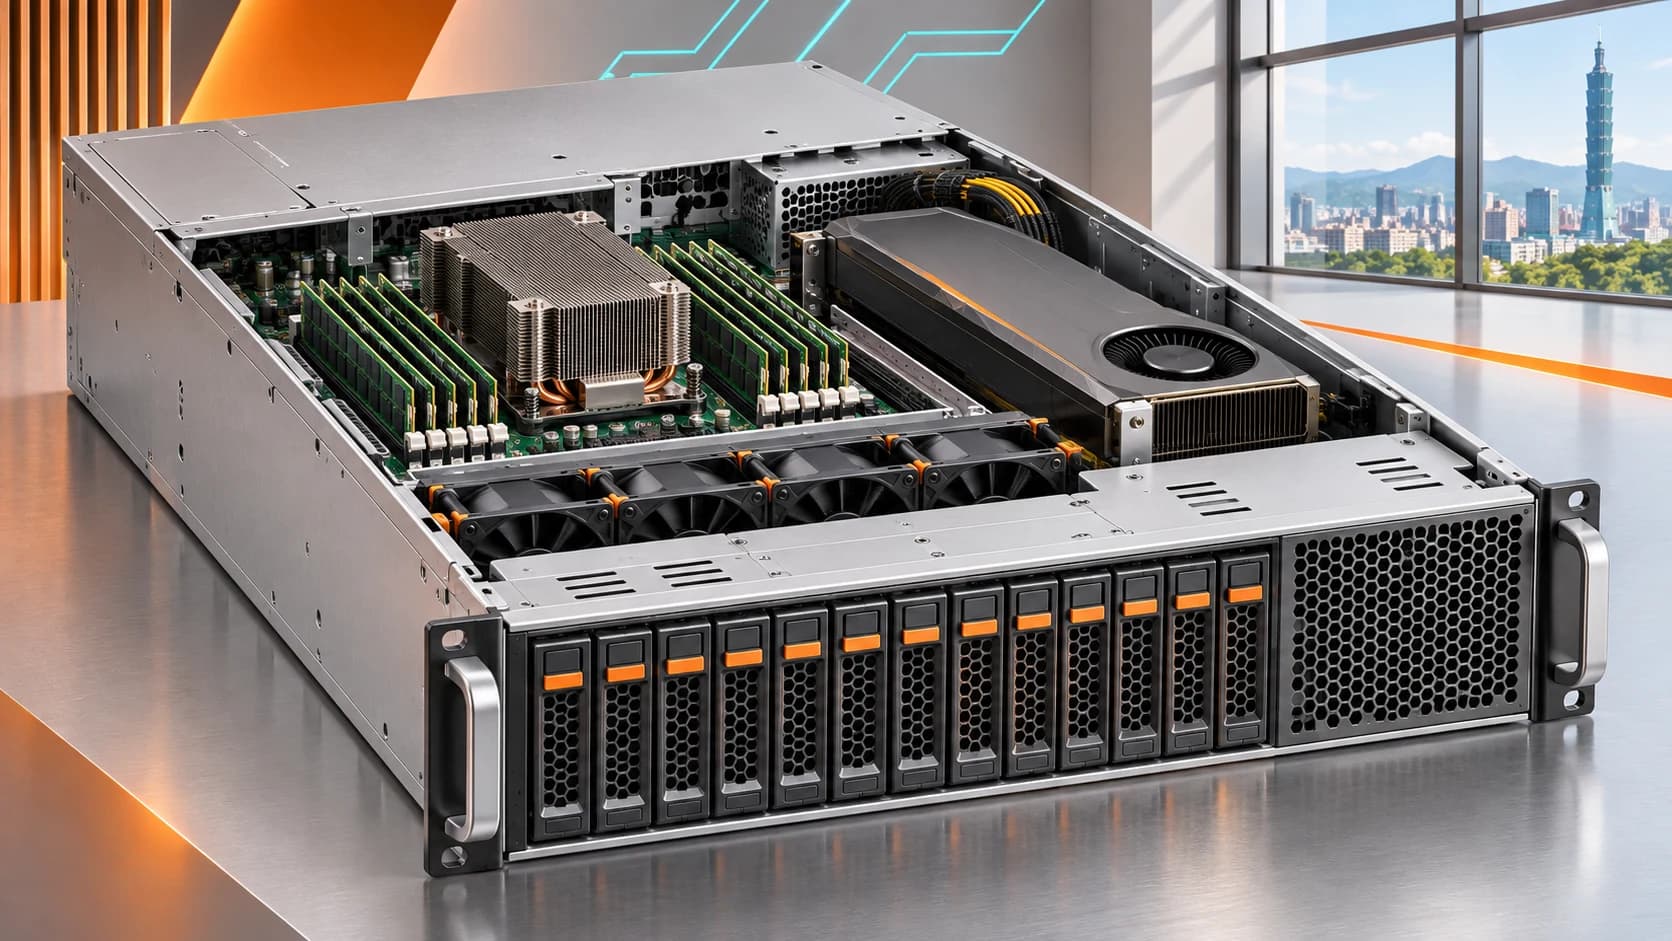
今回 Server Plus は、整備済み HPE ProLiant DL380 Gen10 に NVIDIA RTX A6000 48GB を1枚、システムメモリを128GB搭載し、Strata 推論エンジンで Qwen3.8-Flash-Next を実行しました。既存の予算内でオンプレミス AI を構築する実用的な方法を検討する事例です。
導入記録では、テスト条件下で約95~120 tokens/sのテキスト生成を確認しています。互換APIを通じて社内アプリケーションや開発ツールからアクセスでき、アプリケーション連携に利用可能なオンプレミス推論サービスを構成しています。
今回の構成
| 項目 | 構成 |
|---|---|
| サーバー | HPE ProLiant DL380 Gen10 |
| GPU | NVIDIA RTX A6000 48GB × 1 |
| システムメモリ | 128GB RAM |
| OS | Ubuntu 24.04 |
| NVIDIA ドライバー | 580 系列 |
| 推論エンジン | Strata |
| モデル | Qwen3.8-Flash-Next、GSQ-RCO IQ3_S 量子化 |
| 今回のテキスト生成速度 | 約95~120 tokens/s、投機的デコードを含む |
この速度は記録されたテスト条件での出力性能です。プロンプト長、コンテキスト、同時利用者数、推論設定によって応答速度は変化し、複数ユーザー向けサービスの処理能力を保証するものではありません。
48GB GPU 1枚によるモデル配置構成
Qwen3.8-Flash-Next は混合エキスパート(MoE)アーキテクチャを採用しています。公式説明ではモデル本体が125Bパラメータ、活性化するパラメータが約6Bで、別途 n-gram embedding と MTP モジュールがあります。125Bは全構成要素の重みの合計ではなく、各トークンで全パラメータを計算するわけでもありません。Qwen 公式モデル説明
IQ3_Sファイルの合計は約83.6GBで、GPUとシステムメモリなどの資源を組み合わせて実行します。重み全体が48GBのVRAMに常駐する方式ではありません。公開元の評価では掲載されたテストでBF16に近い結果を示し、品質と容量の実用的なバランスを確認できます。用途ごとの出力品質は独立して検証する必要があります。ISTA-DASLab 量子化モデル説明
Strata はローカル推論と OpenAI/Anthropic 互換 API を提供するため、チャットだけでなく他のソフトウェアの推論サービスとしても利用できます。Strata プロジェクト
DL380 Gen10のシステム構成上の考慮事項
本事例ではシステム全体の計算資源を評価し、GPU、システムメモリ、ストレージ、冷却を構成計画に含めています。
推論がシステムメモリとストレージへのアクセスを伴う場合、メモリ構成、GPU配置、データ転送経路、冷却が性能に影響します。整備済みDL380 Gen10の採用により、ワークロードに適したGPU、メモリ、ストレージへ予算を優先的に配分できます。
GPUの導入では、ライザー、電源ケーブル、電源容量、冷却構成、ファームウェア互換性を確認し、システム全体で負荷検証を実施します。
社内アシスタントから業務アプリケーション連携へ
ローカル推論サービスの構築後は、必要に応じて次の用途を開発できます。
- 文書整理と要約:社内報告書、技術文書、業務記録の処理を支援。
- 開発支援:コードの説明、テストの下書き、デバッグの提案を生成。
- 企業ナレッジベース:文書検索、出典表示、アクセス制御を組み合わせた社内質問応答。
- ワークフロー自動化:API で既存システムに接続し、文章分類、情報抽出、原稿作成を実行。
各用途は同じローカルモデルサービスを共有できます。ナレッジベース、ユーザー権限、業務フローは、それぞれの要件に応じてアプリケーション層で統合します。
AI配置とデータフローの管理
オンプレミス AI の価値は、モデルの実行場所、サービスの入口、データへのアクセス範囲を企業自身が設計できることです。
推論と関連アプリケーションが社内環境で完結する場合、毎回プロンプトや文書を外部モデルサービスへ送る必要はありません。Web検索や外部ツールを追加する場合は、その実際の処理に応じてデータ送信を管理します。
社内向けに正式提供する前に、API 認証、ネットワーク制限、ログ方針、資源監視も設計し、単体の実験環境から管理可能な企業サービスへ移行します。
企業向けオンプレミスAIの導入・拡張計画
本事例は、整備済みDL380 Gen10をオンプレミスAI推論基盤として活用する方法を示しています。
企業は段階的に導入し、実際のワークロードで回答品質、応答速度、利用要件を検証したうえで、処理容量と拡張時期を計画できます。これを予算配分の判断材料とします。
Server Plusは、サーバー、GPU、メモリ、ストレージ、ソフトウェアの統合要件に基づき、既存機器の更新とオンプレミスAI環境を評価し、用途と予算に合った構成計画を支援します。
オンプレミス AI や GPU サーバーをご検討の際は、モデル、用途、同時利用者数を添えて Server Plus にご相談ください。具体的な手順は Strata インストール技術ガイド をご覧ください。
FAQ
今回の構成は何ですか?
HPE ProLiant DL380 Gen10にNVIDIA RTX A6000 48GBを1枚、128GBのシステムRAM、Ubuntu 24.04を搭載し、StrataでQwen3.8-Flash-NextのIQ3_S量子化版を実行しています。
モデル全体が48GBのVRAMに収まりますか?
いいえ。IQ3_Sモデルは約83.6GBです。GPUメモリー、システムRAM、ストレージを組み合わせて実行する構成です。
95~120 tokens/sはすべての用途に当てはまりますか?
導入記録の観測値で、投機的デコードを含みます。入力、コンテキスト長、同時利用数、設定によって速度が変わるため、実際の業務で処理能力を検証してください。