SERVER PLUS INSIGHTS
HPE DL380 Gen10のオンプレミスAI導入手順:StrataでQwen3.8-Flash-Nextを構築
DL380 Gen10の導入構成を基に、Strataのインストール、モデル取得、256Kコンテキスト設定、社内APIの検証、開発ツールとの連携手順を解説します。
2026-11-10 · Server Plus
DL380 Gen10とRTX A6000 48GB向けStrata完全導入ガイド。SC117 GGUF分割ファイル、256K起動、API、Cherry Studio、OpenCodeを解説。
導入の概要
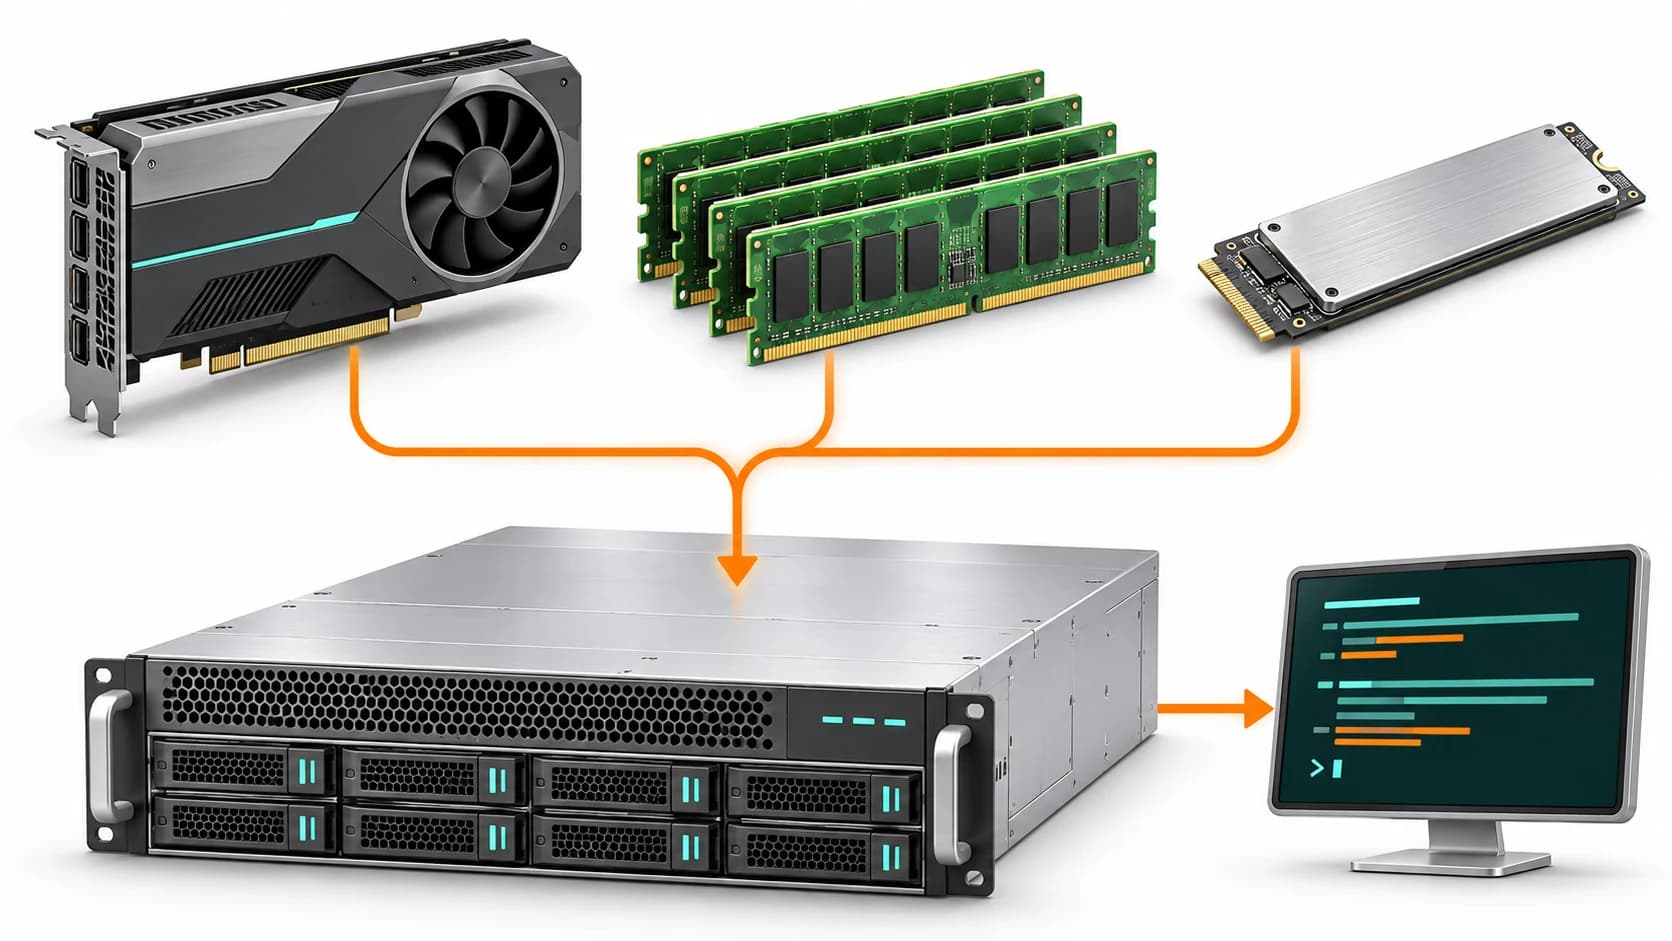
本稿では、HPE ProLiant DL380 Gen10、NVIDIA RTX A6000 48GB 1枚、128GBのシステムメモリで大規模MoEモデルの推論サービスを構築する手順と、クライアントおよび開発ツールとのAPI連携を解説します。
導入手順には、Strata推論エンジンのインストール、Qwen3.8-Flash-NextのGGUF分割ファイル取得、256Kコンテキストでのサービス起動、API検証、Cherry StudioおよびOpenCodeの連携設定を含みます。
本導入で記録したテキスト生成速度は、投機的デコードを含め約95~120 tokens/sです。この数値は今回の検証環境とワークロードに対応し、実際の性能はプロンプト、コンテキスト長、同時リクエスト数に依存します。
1. モデル構造、推論エンジン、量子化構成
Qwen3.8-Flash-Next
Qwen3.8-Flash-Next は MoE とハイブリッド注意機構を採用したオープンウェイトモデルです。公式モデルカードでは言語モデル本体を125Bパラメータ、活性化パラメータを約6Bとし、別途約51Bの n-gram embedding と4Bの MTP を記載しています。
一般に使われる125Bという表記はモデル本体を示し、全構成要素の重みの合計ではありません。512のルーティング対象エキスパートがあり、各トークンで10のルーティング対象と1つの共有エキスパートを使用します。ネイティブのコンテキスト長は262,144 tokensです。Qwen 公式モデルカード
Strata
Strata はローカル推論用のオープンソースツールで、コードは MIT ライセンスです。GPU、システム RAM、適用可能な SSD アクセスを組み合わせ、OpenAI/Anthropic 互換 API を提供します。
本構成はGPUメモリ、システムRAM、ストレージを組み合わせて実行し、重み全体を48GBのVRAMに常駐させる方式ではありません。システムRAM、モデル保存用ストレージ、データ転送経路が推論性能に影響します。StrataはMTPドラフト層による投機的デコードに対応し、その加速効果は実際のワークロードに基づいて評価します。Strata 技術資料
GSQ-RCO 量子化
今回は GSQ-RCO IQ3_S を使用し、モデルの分割ファイルは合計約83.6GBです。公開元の AIME25、GPQA-Diamond、LiveCodeBench v6 の評価では、IQ3_S は全体として BF16 の基準に近い結果を示しています。
これらの結果は公開済み評価におけるIQ3_Sの容量と品質のバランスを示しています。用途ごとの出力品質は個別に検証する必要があります。量子化版はISTA-DASLab、元モデルはQwenチームが提供しています。GSQ-RCO モデル説明
2. 今回のハードウェアとシステム環境
| 項目 | 導入構成 |
|---|---|
| サーバー | HPE ProLiant DL380 Gen10 |
| GPU | NVIDIA RTX A6000 48GB × 1 |
| システムメモリ | 128GB RAM |
| OS | Ubuntu 24.04 |
| NVIDIA ドライバー | 580 系列、CUDA 13 エンジンと組み合わせ |
| モデル | Qwen3.8-Flash-Next GSQ-RCO IQ3_S |
| サービスポート | TCP 11434 |
| コンテキスト設定 | 256K |
公開する構成は表に記載した項目を対象とします。CPU型番とストレージの詳細仕様は導入記録に含まれていません。
インストール前の確認
GPU が認識されていること、VRAM 使用量、モデル保存先の空き容量を確認します。
nvidia-smi
free -h
df -h "$HOME"
nvidia-smi の CUDA バージョンはドライバーが対応する能力を示し、同じバージョンの CUDA Toolkit がインストール済みとは限りません。
モデルファイルは約84GBを使用し、別途推論エンジン、ドラフト層、pack用の容量が必要です。120GB以上の空き容量を確保し、ダウンロードキャッシュ、複数の量子化版、変換ファイルを保存する場合は容量を追加します。
DL380 Gen10 の GPU 構成ではライザー、電源ケーブル、電源容量、冷却を確認します。Strata 自体は root なしでホームディレクトリに導入できますが、GPU ドライバー、システムパッケージ、サービス設定には管理者権限が必要な場合があります。
3. モデルファイルを選ぶ
手順は2通りあります。ISTA-DASLab の量子化を自動ダウンロードする方法と、SC117 の abliterated 派生版を手動で取得する方法です。
| 公開元 | 内容 | 導入方法 |
|---|---|---|
ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF | GSQ-RCO の Q2_0、IQ2_XS、IQ3_XXS、IQ3_S | Strata で選択してダウンロード |
SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF | 拒否応答の挙動を変更したコミュニティ派生版 | 完全なファイル名で取得し、ローカルパスから起動 |
今回の手動導入では、拒否応答の挙動が元モデルと異なるSC117派生版を使用します。企業での導入に際しては、実際の業務データで出力品質と適合性を独立して検証します。元モデルの評価結果は、この派生版に直接適用されません。SC117 モデル説明
量子化ごとの容量
| 量子化 | モデル分割ファイルの合計 |
|---|---|
| Q2_0 | 約66.4GB |
| IQ2_XS | 約68.0GB |
| IQ3_XXS | 約75.8GB |
| IQ3_S | 約83.6GB |
表の数値はダウンロード容量であり、最低VRAM容量を示すものではありません。リソース計画では、コンテキスト長、同時リクエスト数、画像リーダー、エンジンの作業領域に加え、GPUメモリとシステムRAMの配分を考慮します。本構成はRTX A6000 48GBと128GB RAMでIQ3_Sを使用します。容量資料
4. Strata のインストール
DL380 Gen10 の Linux ターミナルで実行します。スクリプトを取得し、内容を確認してからインストールします。
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
less install.sh
sh install.sh
export PATH="$HOME/.local/bin:$PATH"
strata --version
インストール先は ~/.local/share/strata、コマンドのパスは ~/.local/bin/strata です。PATH設定をユーザーのシェル起動ファイルに追加し、再ログイン後も同じコマンドパスを使用できるようにします。
latest は上流の更新に追随します。再現のため strata --version とエンジンのバージョンを記録します。インストール資料
本構成ではNVIDIA 580系列ドライバーとCUDA 13エンジンを使用します。別のドライバーバージョンを使用する場合は、エンジンパッケージの最低要件に基づいて互換性を確認し、対応するパッケージを選択します。
5. モデルのダウンロード
5.1 ISTA-DASLab 版を Strata で取得
標準の量子化版を使う場合は次のように実行します。
strata launch --family qwen --model iq3_s \
  --access lan --port 11434 --context 256k \
  --save-preset qwen
選択したモデルと機能に必要な素材がダウンロードされます。
本方式または次節の手動導入方式のいずれかを選択します。同一ホストのTCP 11434は単一のサービスで待ち受けます。
5.2 SC117 派生版の分割ファイルを手動取得
今回のモデルパスは SC117 IQ3_S を使用します。Ubuntu 24.04 ではシステム Python を直接変更せず、仮想環境に Hugging Face ツールをインストールします。
python3 -m venv "$HOME/.venvs/strata-download"
source "$HOME/.venvs/strata-download/bin/activate"
python -m pip install -U "huggingface_hub[hf_xet]"
mkdir -p "$HOME/strata-models"
cd "$HOME/strata-models"

hf download SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF \
  IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00001-of-00002.gguf \
  IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-IQ3_S-00002-of-00002.gguf \
  mmproj-Qwen3.8-Flash-Next-BF16.gguf \
  --local-dir SC117-abliterated
venv がない場合は管理者に対応する python3-venv の導入を依頼します。2つの GGUF は元の名前のまま同じ IQ3_S ディレクトリに置きます。mmproj は画像入力用の投影モデルで、主モデルの代わりにはなりません。
上記コマンドは2つのGGUF分割ファイルと投影モデルを完全なパスで指定し、取得対象を明確にしています。Hugging Face CLIのinclude/excludeパターンも、モデルリポジトリのディレクトリ構造に応じて利用できます。Hugging Face CLI 資料
取得後、モデルのインポート計画を確認します。
strata models import \
  "$HOME/strata-models/SC117-abliterated/IQ3_S" --plan
起動前に2つのGGUF分割ファイルと対応する量子化形式が認識されていることを確認します。認識メッセージはバージョンによって異なるため、ファイル数、量子化形式、実行計画を総合的に確認します。
6. 256K コンテキストで起動
6.1 実行計画を確認
strata launch \
  --model-path "$HOME/strata-models/SC117-abliterated/IQ3_S" \
  --access lan --port 11434 --context 256k \
  --no-tui --plan
モデルの場所、エンジン、待受方法、資源計画を確認します。
6.2 サービスを起動
nohupでサービスを起動し、標準出力とエラーメッセージをログファイルに保存します。
nohup strata launch \
  --model-path "$HOME/strata-models/SC117-abliterated/IQ3_S" \
  --access lan --port 11434 --context 256k \
  --no-tui --save-preset SC117 \
  > "$HOME/strata-launch.log" 2>&1 &

tail -f "$HOME/strata-launch.log"
本導入では、初回のpackとドラフト層の準備に約5~10分、その後のロードに約75秒を要しました。実際の時間は、ダウンロード速度、キャッシュ状態、ストレージ性能、ソフトウェアバージョンに依存します。
サービスの準備完了後に、モデル一覧とAPI応答を検証します。一部のStrataバージョンではサービスがバックグラウンドで維持されるため、状態コマンドとAPI検査で稼働状況を確認します。
6.3 管理コマンド
strata launch --status
strata launch --show-key --preset SC117
strata launch --stop --preset SC117
strata launch --preset SC117 --no-tui
strata logs --follow
各コマンドは状態確認、キー確認、停止、再起動、ログ監視に対応し、管理上の必要に応じて個別に実行します。API keyは適切に保管し、公開文書、スクリーンショット、バージョン管理リポジトリには含めない運用とします。
6.4 主なオプション
| オプション | 用途 |
|---|---|
--model-path | ダウンロード済みローカルモデルのディレクトリ |
--access local | このコンピューターだけから接続 |
--access lan | LAN 接続と API key の生成 |
--access cloudflare/tailscale | 選択した方法で外部接続を構成。対応ツールと設定が必要 |
--context 256k | 今回のコンテキスト設定 |
--mtp off | 資源・性能比較のためドラフト層を無効化 |
--port 11434 | API ポートを指定 |
--save-preset SC117 | 起動設定を保存 |
本導入のコンテキスト設定は256Kです。長いプロンプトは処理時間とメモリ需要を増加させるため、入力長と同時リクエスト数に応じてリソースを計画します。MTPの効果は、同じワークロードで有効時と無効時を比較して評価します。オプション資料
7. OpenAI 互換 API の呼び出し
LANモードのAPIは http://<サーバーIP>:11434/v1 です。以下はlocalhostで検証します。別ホストから接続する場合は、サーバーの内部ネットワークアドレスを使用します。
キーを直接コマンド履歴に残さないよう Bash で入力します。
read -rsp 'Strata API key: ' STRATA_API_KEY
printf '\n'
export STRATA_API_KEY
export STRATA_BASE_URL=http://127.0.0.1:11434/v1

curl -fsS "$STRATA_BASE_URL/models" \
  -H "Authorization: Bearer $STRATA_API_KEY"
本導入で返されたモデルIDは swift-1.5-iq3_s です。実際の連携では、/v1/models が返すIDをリクエストの model フィールドに指定します。
curl -fsS "$STRATA_BASE_URL/chat/completions" \
  -H "Authorization: Bearer $STRATA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "swift-1.5-iq3_s",
    "messages": [
      {"role": "user", "content": "企業向けオンプレミス AI の用途を日本語で説明してください。"}
    ],
    "max_tokens": 1024,
    "chat_template_kwargs": {"enable_thinking": false}
  }'
思考モードと出力予算
モデルは回答に先立って推論内容を生成し、reasoning_content フィールドで返す場合があります。出力予算が不足すると推論段階でトークンを消費し、最終的な content が空になる可能性があります。
一般的な対話やツール前処理では思考モードを無効にして検証できます。推論を必要とする用途では有効にし、十分な出力予算を設定します。エラー、終了理由、トークン使用量も確認し、応答の完全性を検証します。
本導入では tools/function callingによる tool_calls の返却も検証しました。ツール実行の承認、引数検証、結果返却はクライアントが担当し、OS権限を明示的に管理します。
StrataはAnthropic互換インターフェースも提供します。クライアントのAnthropic base URLにはサービスのルートを指定し、/v1 は追加しません。推論処理は引き続きローカルに配置したQwenモデルが実行します。API と連携説明
8. チャット・開発ツールとの連携
Cherry Studio
OpenAI 互換プロバイダーを追加し、http://<サーバーIP>:11434/v1 と Strata の API key を設定します。/v1/models の結果に従ってモデルを追加し、ツール利用が必要な場合は関数呼び出しを有効にします。
Web検索はTavily、Exa、SearXNGなどの外部サービスで結果を取得し、ローカルモデルで処理できます。検索キーワードの抽出に追加の推論が不要な場合は、次のカスタムパラメーターで思考モードを無効にします。
{
  "chat_template_kwargs": {
    "enable_thinking": false
  }
}
外部検索ではクエリが選択したサービスへ送信されます。企業はローカル推論と外部ツールのデータフローを分けて設計し、データ分類とアクセスポリシーに基づいて外部クエリを管理します。
OpenCode
既存設定をバックアップした後、次の連携コマンドを実行します。
strata connect opencode --write生成された ~/.config/opencode/opencode.json を確認します。OpenCodeとStrataが別ホストの場合は、baseURL をサーバーの内部APIアドレスに変更し、モデルID、API key、入出力上限を確認します。本構成では limit.input の設定を保持します。
初回起動では provider プラグインの取得が発生する場合があるため、外向き通信を事前に確認します。
Claude Code
次の環境変数を使用してAnthropic互換インターフェースに接続します。
export ANTHROPIC_BASE_URL=http://127.0.0.1:11434
export ANTHROPIC_API_KEY="$STRATA_API_KEY"
別ホストの場合は localhost をサーバーのアドレスへ変更します。他のツールは strata connect で対応一覧を確認し、strata connect <ツール名> で個別設定を取得します。Strata 連携入口
9. 今回の性能と検証方法
本DL380 Gen10環境で記録した性能は次のとおりです。
| 環境 | テキスト生成 | プロンプト処理 |
|---|---|---|
| RTX A6000 48GB+128GB RAM | 約95~120 tokens/s | 約1,000~1,500 tokens/s |
値には投機的デコードが含まれます。出力速度と入力処理速度は別の指標であり、リクエスト送信から回答完了までの平均速度と同一ではありません。
これらは本導入における観測値であり、異なるハードウェアやエンジン間の標準化された比較試験は含みません。本構成を評価するための参考値として利用できます。
比較時はモデル・エンジンのバージョン、実際の起動引数、CPU、GPU、RAM、ストレージ、入出力長、思考モード、MTP、並列数を記録します。同じプロンプトで初回応答時間、出力速度、資源使用量を測定し、複数ユーザーへの適合性を判断します。